
全3回シリーズ 第1回 — トークノミクスの課題と、負荷ではなくキャッシュ状態に基づくリクエストルーティング
エージェンティック・コーディングは、単なるチャットではありません。チャットボットのセッションでは、コンテキストが2Kトークンから4Kトークン程度に増えることがあります。一方、コーディングエージェントは、これまでに参照した情報のほぼすべてを、ターンごとに再送します。大規模なコードベースで5ターンやり取りすると、再送されるコンテキストは64Kトークンから480Kトークンまで増加し、合計で約125万トークンが処理されることになります。この非線形な負荷増大こそが、単純な vllm serve によるデプロイメントが限界を迎える原因です。50万トークン規模のリポジトリコンテキストを処理すると、Time-to-First-Token(TTFT)は30秒を超え、同時利用可能なユーザー数は10人未満にまで低下します。
全3回の本シリーズでは、Kubernetes上でこれを実現するための具体的な設計方法を解説します。第1回では、基本概念とルーティング層を扱います。第2回では、PDディスアグリゲーションとキャッシュオフロードについて解説します。第3回では、スケジューリング、オートスケーリング、そしてベンチマーク結果を取り上げます。
PrefillとDecodeは対照的なワークロードである
LLMの推論リクエストはすべて、リソース特性が根本的に異なる2つのフェーズを経て処理されます。この違いを理解することが、この後の議論を理解するうえで重要なポイントとなります。
Prefillはコンピュートバウンドです。 プロンプト全体を1回のフォワードパスで並列処理するため、GPUのFLOPSを最大限に活用できるワークロードです。
Decodeはメモリ帯域幅バウンドです。 トークンは1つずつ生成され、各ステップでHBMからKVキャッシュ全体を再読み込みする必要があります。移動する1バイトあたりの演算量が非常に少ないため、GPUは計算処理よりもメモリ帯域幅の待ち時間に多くの時間を費やすことになります。
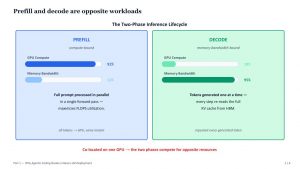
この2つのフェーズは、単に異なるリソースを必要とするだけではありません。1つのインスタンス上で同居させると、同じリソースプールをめぐって互いに競合します。単一インスタンス上では、長時間にわたるPrefill処理によって、ほかの処理中のリクエストのDecodeステップがブロックされます。その結果、ユーザー側ではInter-Token Latency(ITL)のジッターとして影響が現れます。
標準のKubernetes Serviceはキャッシュを認識できない
さらに、その上にルーティングの問題があります。ラウンドロビンやLeast Connections方式のロードバランシングには、あるリクエストのKVキャッシュをすでにメモリ上に保持しているPodがどれなのかを認識する仕組みがありません。そのため、リクエストを適切でないPodへルーティングし、本来発生する必要のなかったキャッシュミスを引き起こしてしまいます。
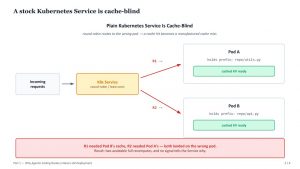
チャットのトラフィックであれば、これは小さな非効率に過ぎません。しかし、Agentic Codingでは話が違います。プロンプトの大部分が、システムがすでに処理したコンテキストで構成されているため、キャッシュヒットになるか、数十万トークンを再計算することになるかの違いにつながります。
キャッシュ状態と負荷の両方に基づくルーティング
その解決策となるのが、各候補ワーカーを2つのシグナルで同時に評価し、最もコストの低いワーカーへ振り分けるルーターです。
シグナル1 — KVのオーバーラップ。 KVインデクサーは、受信したリクエストのトークンをハッシュ化してブロックハッシュを生成し、階層化されたプレフィックスキャッシュのヒット状況を追跡します。これにより、特定のワーカー上ですでにどの程度のプロンプトがキャッシュされているかを推定できます。オーバーラップが大きいほどPrefillで必要となる処理量が減り、結果としてTTFTを直接短縮できます。
シグナル2 — リアルタイム負荷。 スロットトラッカーが各ワーカーで処理中のPrefillおよびDecodeのシーケンス数を監視し、現在の負荷を推定します。これにより、すでに処理能力の上限に達しているワーカーに、さらにリクエストが集中するのを防ぎます。
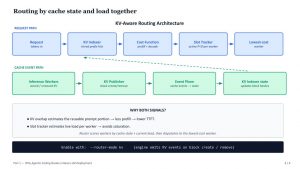
これらを組み合わせることで、以下のルーティングコスト関数が構成されます。
cost = overlap_score_weight × prefill_blocks + decode_blocks
出典:https://docs.nvidia.com/dynamo/dev/knowledge-base/modular-components/router/routing-concepts
prefill_blocks は、まだPrefill処理が必要なトークン数をブロックサイズで割った値です。対象ワーカーですでにプレフィックスの大部分がキャッシュされているほど、この値は小さくなります。
decode_blocks は、入力トークン数とワーカー上でアクティブなシーケンス数から推定され、リクエストの処理が完了するたびに更新されます。
重みを 1 に設定すると、ルーターはキャッシュヒットを優先することと負荷分散を均等に考慮してルーティングを行います。
キャッシュの重複率がそれぞれ 8/10、6/10、2/10、0/10 で、アクティブなDecode負荷がそれぞれ 12、4、3、1シーケンス の4つの候補ワーカーがあるとします。
| Worker | Cache Overlap | Prefill_blocks | Decode_blocks | Cost |
| W1 | 8/10 | 2 | 12 | 14 |
| W2 | 6/10 | 4 | 4 | 8 ✓ selected |
| W3 | 2/10 | 8 | 3 | 11 |
| W4 | 0/10 | 10 | 1 | 11 |
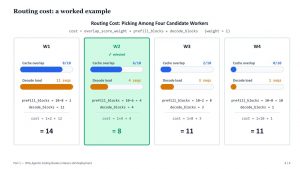
W1はキャッシュヒット率が最も高いものの、負荷が大きくなっています。一方、W2は、一定のキャッシュヒット率を維持しながら現在の負荷を低く抑えているため、より優れた選択肢となります。これはまさに、コスト関数が考慮するように設計されたトレードオフです。
実際の設定では、--router-mode kv という単一のフラグで有効化できます。エンジンがブロックの作成時と削除時にKVキャッシュのイベントを発行することで、ルーターは常に最新の状態を維持できます。
ルーティングだけでは解決できないこと
KV-awareルーティングによって、意図的に発生していたキャッシュミスは解消できます。しかし、根本的なリソース競合そのものを解決することはできません。PrefillとDecodeは依然として同じGPUと同じバッチを共有するため、リポジトリ全体を対象とするような長時間のPrefill処理が発生すると、そのワーカー上のほかのリクエストのDecode処理まで停止してしまいます。
パート2では、PrefillとDecodeの2つのワークロードを専用のGPUプールに分離することで、このリソース競合を解消する「Prefill-Decode Disaggregation(Prefill-Decode分離)」について解説します。
———–
著者:
Duong Nguyen Thai は、FPT AI FactoryのAI Platform Engineerとして、大規模なAI推論プラットフォームの構築・運用に携わっています。また、CNCF Kubestronautとして、CKA、CKAD、KCNA、KCSA、CKSを含むKubernetes認定資格をすべて取得しています。
主な専門領域は、スケーラブルなAIインフラストラクチャ、Kubernetes、そしてAIモデルを本番環境で提供するための高信頼なシステムの構築・運用です。